榜单计分为 100 × mean(clip(1 - raw_i / 0.007, 0, 1)):直接使用每个视频报告保留的 Gram 距离,先计分再平均,不反推 error_ref 均值。无法对应到逐视频报告的旧成绩保留历史已发布汇总,网页悬停说明该状态。
本指标用于评估生成 rollout 内视觉风格(色彩、纹理与粗粒度外观统计)的跨场景稳定性。给定按评测协议抽取的 anchor 帧序列 { I t } t = 1 T \{I_t\}_{t=1}^{T} { I t } t = 1 T T ≥ 2 T \geq 2 T ≥ 2 I 1 I_1 I 1 I d + 1 I_{d+1} I d + 1 d ∈ [ 1 , T − 1 ] d \in [1, T-1] d ∈ [ 1 , T − 1 ] I 1 I_1 I 1 不使用 ground-truth reference 参与打分。
对每帧 I t I_t I t 512 × 512 512 \times 512 512 × 512 128 × 128 128 \times 128 128 × 128 ToTensor 及 ImageNet 均值–方差归一化,再送入 VGG19 features 前向传播。在卷积层 c o n v 1 , … , c o n v 5 \mathrm{conv}_1, \ldots, \mathrm{conv}_5 conv 1 , … , conv 5 F t , l ∈ R C × H × W F_{t,l} \in \mathbb{R}^{C \times H \times W} F t , l ∈ R C × H × W
G ( F ) = v e c ( F ) v e c ( F ) ⊤ C ⋅ H ⋅ W (1) G(F)
=
\frac{
\mathrm{vec}(F)\,\mathrm{vec}(F)^{\top}
}{
C \cdot H \cdot W
}
\tag{1} G ( F ) = C ⋅ H ⋅ W vec ( F ) vec ( F ) ⊤ ( 1 ) 其中 v e c ( ⋅ ) \mathrm{vec}(\cdot) vec ( ⋅ ) d + 1 d+1 d + 1 l l l
δ d , l = M S E ( G ( F d + 1 , l ) , G ( F 1 , l ) ) (2) \delta_{d,l}
=
\mathrm{MSE}\!\left(
G(F_{d+1,l}),\,
G(F_{1,l})
\right)
\tag{2} δ d , l = MSE ( G ( F d + 1 , l ) , G ( F 1 , l ) ) ( 2 ) 单帧距离为五层距离之和:
d d = ∑ l ∈ { c o n v 1 , … , c o n v 5 } δ d , l (3) d_d
=
\sum_{l \in \{\mathrm{conv}_1, \ldots, \mathrm{conv}_5\}}
\delta_{d,l}
\tag{3} d d = l ∈ { conv 1 , … , conv 5 } ∑ δ d , l ( 3 ) 原始分数取后续 anchor 帧距离的算术平均(越低越好 ):
r a w = 1 T − 1 ∑ d = 1 T − 1 d d (4) \mathrm{raw}
=
\frac{1}{T-1}
\sum_{d=1}^{T-1} d_d
\tag{4} raw = T − 1 1 d = 1 ∑ T − 1 d d ( 4 ) 归一化采用配置的经验界 ε min = 0 \varepsilon_{\min}=0 ε m i n = 0 ε max = 0.007 \varepsilon_{\max}=0.007 ε m a x = 0.007 higher_is_better=false)。先将 raw 钳位至经验区间,再映射为 [ 0 , 1 ] [0,1] [ 0 , 1 ] 越高越好 的归一化分数:
r a w ′ = c l i p ( r a w , ε min , ε max ) (5) \mathrm{raw}'
=
\mathrm{clip}(\mathrm{raw},\, \varepsilon_{\min},\, \varepsilon_{\max})
\tag{5} raw ′ = clip ( raw , ε m i n , ε m a x ) ( 5 ) S s t y l e = 1 − r a w ′ − ε min ε max − ε min (6) S_{\mathrm{style}}
=
1
-
\frac{
\mathrm{raw}' - \varepsilon_{\min}
}{
\varepsilon_{\max} - \varepsilon_{\min}
}
\tag{6} S style = 1 − ε m a x − ε m i n raw ′ − ε m i n ( 6 ) Audit manifest: docs/assets/metric_examples/curated_same_case_manifest.json.
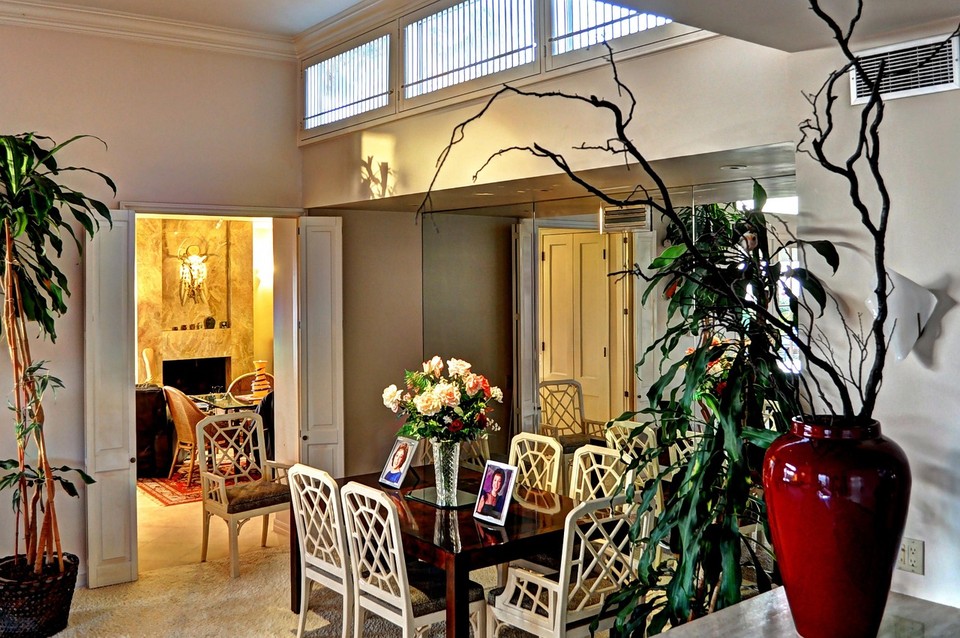
输入图像
输入已核验 · 同一 benchmark case · gap 1.0000
image_static_photorealistic_dining_spaces_0150套件: image_static 场景: photorealistic / indoor / dining_spaces
基准 prompt target
Camera pan left. A living area with fireplace, chairs, and wall sculpture.
prompt source: prompt_target
两条视频的首帧都已通过与展示输入的几何匹配核验;高低标签只比较当前 metric。
较高指标分 分数 1.0000
较低指标分 分数 0.0000
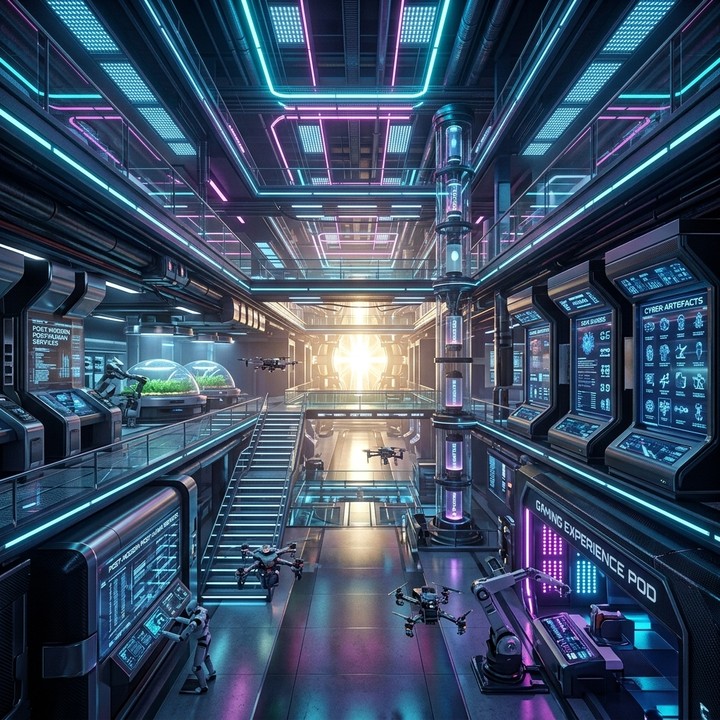
输入图像
输入已核验 · 同一 benchmark case · gap 1.0000
image_static_stylized_public_spaces_0146套件: image_static 场景: stylized / indoor / public_spaces
基准 prompt target
Camera pan left. A futuristic facility with control panels, holographic displays, and neon lights. Camera move left. A futuristic facility with interactive kiosks, virtual reality stations, and holographic displays. Camera pull out. A futuristic facility with security checkpoint, automated doors, and interactive kiosks.
prompt source: prompt_target
两条视频的首帧都已通过与展示输入的几何匹配核验;高低标签只比较当前 metric。
较高指标分 分数 1.0000
较低指标分 分数 0.0000
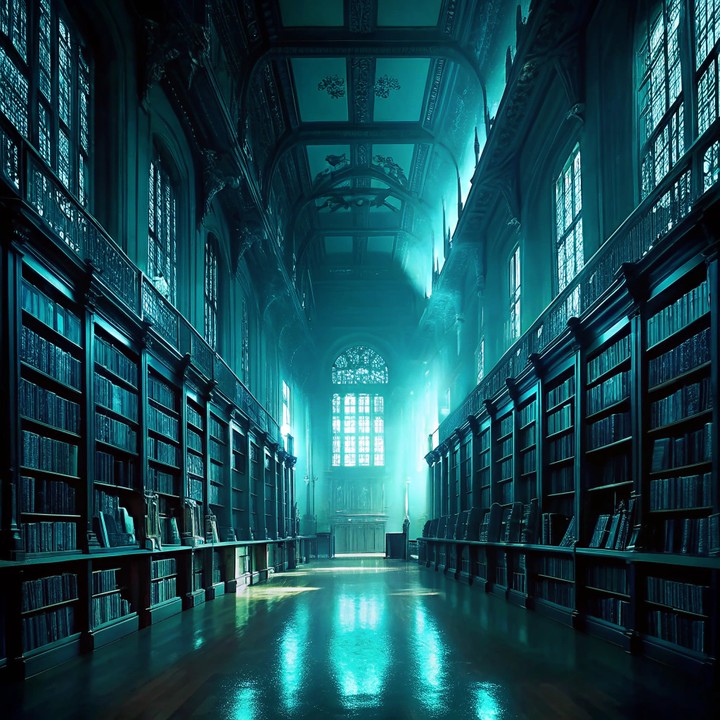
输入图像
输入已核验 · 同一 benchmark case · gap 1.0000
image_static_stylized_public_spaces_0059套件: image_static 场景: stylized / indoor / public_spaces
基准 prompt target
Camera orbit right. A grand library hall with bookshelves, reading table, and chairs.
prompt source: prompt_target
两条视频的首帧都已通过与展示输入的几何匹配核验;高低标签只比较当前 metric。
较高指标分 分数 1.0000
较低指标分 分数 0.0000
Very Deep Convolutional Networks for Large-Scale Image Recognition
Karen Simonyan and Andrew Zisserman.
arXiv:1409.1556, 2014.
https://arxiv.org/pdf/1409.1556